一、初识Node
Node.js是一个基于V8 JavaScript引擎的JavaScript运行时环境
1.1 浏览器
浏览器内核
- Gocko:早期被Netscape 和Firefox浏览器使用
- Trident:微软开发,被应用于IE4-IE11浏览器使用,但是Edge浏览器已经转向Blink
- Webkit:苹果基于KHTML开发、开源,用于Safari、Google Chrome往前的版本也在使用
- Blink:Webkit的一个分支,Google开发,目前应用于Google Chrome、Edge、Opera
事实上,我们经常说的浏览器内核指的是浏览器的排版引擎(渲染引擎)
渲染引擎的工作过程
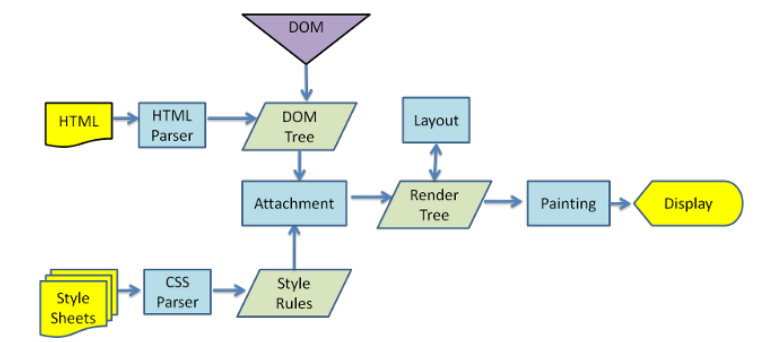
我们知道,浏览器在执行代码时,会将html代码编译成DOM Tree,如果在编译过程中,遇到了js代码,就会停下来去编译js代码,为什么?
因为js代码可以操作DOM,所以浏览器将HTML解析的DOM和JavaScript操作之后的DOM放在一起来生成最终的DOM树,而不是频繁的去生成新的DOM树。
js代码的执行需要JavaScript引擎
JavaScript引擎
为什么需要JavaScript引擎呢?
1、事实上我们编写的JavaScript无论是交给浏览器或者Node执行,最后都是需要被CPU执行的
2、但是CPU只认识自己的指令集(机器语言)
3、所以我们需要JavaScript引擎帮助我们将JavaScript代码翻译成CPU指令来执行
常见的JavaScript引擎:
a、SpiderMonkey:初代JavaScript引擎,由Brendan Eich开发(JavaScript作者)
b、Chakra:微软开发,用于ie浏览器
c、JavaScriptCore:WebKit中的JavaScript引擎、Apple公司开发
d、V8:Google开发的强大的JavaScript引擎
1.2 基本使用
如何通过node执行js代码?
- 方式一:将代码交给浏览器
- 方式二:将代码载入到node环境中执行
如果希望把js文件交给node执行,需要在终端命令node js文件名的方式来载入和执行对应的js文件
//方式二
//终端 执行index.js
node index.js
Node的REPL
node提供也一个REPL交互环境,可以在其中演练简单的代码
通过在终端输入node命令开启
1.3 传递参数
在某些情况下,我们需要给node传递一些参数
//传递linming、age=18
node index.js linming age=18
这样子来传递参数其实是存放于全局对象process中的(内置process中的argv属性)
我们可以在index.js中将argv中的参数遍历出来
// 打印全局对象
// console.log(process);

process.argv.forEach(item=>{
    console.log(item);
})
1.4 常见的全局对象
__dirname
获取当前文件所在的路径
console.log(__dirname);
//输出:C:\Users\Administrator\Desktop\Nodejs\code\01-基础
__filename
获取当前文件所在的路径和文件名称
console.log(__filename);
//输出:C:\Users\Administrator\Desktop\Nodejs\code\01-基础\index.js
process对象
process提供了node进程中相关的信息。比如node的运行环境、参数信息等
console对象
提供了简单的调试控制台
1、console.log
最常用的输出内容的方式
2、console.clear
清空控制台 console.clear();
3、console.trace
打印函数的调用栈
定时器函数
1、setTimeout(callback,delay)
延迟一些时间后执行一次
2、setInterval(callback,delay)
每隔多长时间重复执行一次
3、setImmediate(callback[,...args])
callback的 I/O事件后的回调的“立即”执行。区别于setTimeout
4、process.nextTick(callback[,...args])
添加到下一次的tick队列中
global对象
global是一个全局对象,上边提到的process、console、setTimeout等都被放在global中
注意:global与window对象是不同的
在浏览器中,全局变量都是在window上的,比如document、setInterval、setTimeout、alert、console等等。在node中,也有一个类似的global对象,里边存放了许多其他对象。
二、JavaScript的模块化
2.1 CommonJS规范
CommonJS是一个规范,最初提出来是在浏览器以外的地方使用,并且当时被命名为ServerJS,后来为了体现它的广泛性,修改为CommonJS。
Node是CommonJS在服务器端的一个具有代表性的实现。
1、在node中每一个js文件都是一个单独的模块
2、这个模块中包括CommonJS规范的核心变量:exports、module.exports、require
exports与require
案例理解
创建main.js 与bar.js ,在main.js中导入bar.js模块
//main.js

// require("./bar") 相当于导入了exports(本质是指向了与exports一样的内存地址)

//这里变量bar==exports (也指向了与exports一样的对象)
const bar = require('./bar')

// 这里利用了ES6的解构赋值
// const {name,age,fn} = require('./bar')

console.log(bar.name);
console.log(bar.age);
bar.fn();
//bar.js
const name = "linming";
const age = 18;

function fn() {
    console.log("hello " + name);
}

//exports默认是一个全局空对象
exports.name = name;
exports.age = age;
exports.fn = fn;
从上面的例子我们可以知道,exports是一个默认存在的空的对象,我们向外导出的变量变成了exports的属性(方法),用require导入的其实就是exports这个对象。
module.exports
在Node中我们进行导出时,往往不用exports,而是通过module.exports导出的。
那么exports与module.exports有什么关系吗?
1、CommonJS中是没有module.exports这个概念的,但是为了实现模块的导出,Node中使用的是Module的类,每一个模块都是module的一个实例。
2、所以在Node中真正用于导出的其实根本不是exports,而是module.exports
在Node源码中规定module.exports = exports,所以二者指向同一个引用。即module.exports = exports=require()
require细节
require是一个函数,可以帮助我们引入一个文件(模块)中导入的对象。
require的查找规则是怎么样的呢?
requiere(X)
1、情况一:
X是一个核心模块,比如path。那么直接返回核心模块,并停止查找
2、情况二:
X是以 ./ 或 ../ 或 / 开头的
查找规则:将X当做一个文件在对应目录下查找,如果有拓展名,按照拓展名查找;没有拓展名,则查找文件X>查找X.js >查找X.json > 查找X.node文件,直到找到为止。或者将X当做一个文件夹查找,会依次去查找上述规则文件夹下的index.js文件
3、情况三:
直接是一个X(没有路径),并且X不是一个核心模块
查找规则:会循着文件路径,依次去每个文件夹下的node_modules文件夹下查找。
模块的加载过程
结论一:模块在被第一次引入时,模块中的js代码会被运行一次
结论二:模块被多次引入时,会缓存,最终只加载(运行)一次
为什么只加载一次呢?因为每个模块对象module都有一个属性loaded,默认为false,为true时表示已经被加载了
结论三:存在循环引用、也只加载一次。而且按照的是图结构的深度优先搜索的顺序
CommonJS规范的缺点
1、CommonJS加载模块是同步的。
这意味着只有等到对应的模块加载完毕,后续的内容才能被运行(从上往下),这在服务器中不会有什么问题,因为服务器加载的js文件都是本地文件,加载速度非常快。
但是如果它应用于浏览器。因为浏览器需要从服务器中将文件下载下来,再运行。采用同步的方式则意味着之后的js代码无法正常运行。
2.2 ES Module
ES Module与CommonJS的模块化有一些不同之处
1、它使用了import和export关键字
2、另一方面它采用编译期的静态分析,并且加入了动态引用的方式。
3、采用ES Module将自动采用严格模式: use strict
4、ES Module加载模块是异步的
导入导出的三种方式
注:es6的模块化需要在服务器上运行才有效。(使用vscode的live serve插件)
//创建index.html
<body>
    <script src="./index.js" type="module"></script>
</body>
注:下面的演示,并不是一一对应关系
1、方式一
//foo.js
//在语句声明的前面直接加上export关键字
export const name = 'linming';
export const age = 18;
export const sayHello = function (name) {
    console.log("你好"+name);
}

//index.js
//import {标识符列表} from '模块'
import { name,age,sayHello } from "./js/foo.js"; //拓展名不能省
console.log(name);
console.log(age);
sayHello('lin')
2、方式二
//foo.js
//将所有需要导出的标识符,放到export后面的 {}中
const name = 'linming';
const age = 18;
const sayHello = function (name) {
    console.log("你好"+name);
}
export {name,age,sayHello}
// 注:{}中统一导出,{}大括号不是一个对象

//index.js
//导入时给标识符起别名
import {name as wName, age as wAge, sayHello as Wfn} from './js/foo.js'
console.log(wName);
console.log(wAge);
Wfn('linming')
3、方式三
//foo.js
//导出时给标识符起一个别名
export {
    name as fName,
    age as fAge,
    sayHello as fFn
}

//index.js
//通过 * 将模块功能放到一个模块功能对象(a module object)上
import * as obj from './js/foo.js'
console.log(obj.fName);
console.log(obj.fAge);
obj.fFn('linming')
default用法
前面学习的导出功能都是有名字的导出,比如导出
export const sayHello = function () {}
//在导出时指定了名字,在导入import时需要知道具体的名字
但是,默认导出(default export)可以不用指定名字,并且在导入时可以自己来指定名字。
//导出
export default function () {}
//导入import fn from '路径'
注:在一个模块中,只能有一个默认导出
Node对ES Module的支持
在Node的current版本(v14.13.1)中,支持es module。
方式一:在package.json中配置 type:module
方式二:文件以.mjs结尾,表示使用的是ES Module
//演示方式二
//js/bar.mjs
const name = 'ming';
const sayHello = function (name) {
    console.log("你好" + name);}
export {
    name,
    sayHello
}

//main.mjs
import { name,sayHello } from "./js/bar.mjs";
console.log(name);
sayHello("明明");
三、常见的内置模块
3.1 path
resolve
path模块用于对路径和文件进行处理,提供了很多很好用的方法
例如:不同操作系统上的路径可能是不同的"\", "/" ,"\\" ,如果项目想要部署到不同的系统,直接使用原先的路径可能是错误的。但是利用path可以屏蔽他们之间的差异。
const path = require('path');
const basePath = '/User/lingming';
const fileName = 'test.vue';

// 拼接路径:通过拼接字符串的方式(不推荐)
// const myPath = basePath + '/' + fileName;

const myPath = path.resolve(basePath,fileName);
console.log(myPath);
dirname、basename、extname
1、dirname:获取文件的父文件夹
const path = require('path');
// 定义路径信息
const filepath = '/User/ming/index.js';

// 获取文件的父文件夹
console.log(path.dirname(filepath));
//输出:/User/ming
2、basename:获取文件名
const path = require('path');

// 定义路径信息
const filepath = '/User/ming/index.js';

// 获取文件名
console.log(path.basename(filepath));
//输出:index.js
3、extname:获取文件拓展名
const path = require('path');

// 定义路径信息
const filepath = '/User/ming/index.js';

// 获取文件拓展名
console.log(path.extname(filepath));
//输出: .js
join
用于路径拼接
const path = require('path');
const basepath = 'User/ming/';
const filename = '/index.js';

const filepath = path.join(basepath,filename);
console.log(filepath);
join 与 resolve的区别
resolve会判断拼接的路径的字符串中,是否有以./或../或/开头的路径
const filepath2 = path.resolve(basepath,filename);
console.log(filepath2);
3.2 fs文件系统
fs(File System),表示文件系统
对于任何一个为服务器端服务的语言或者框架通常都会有自己的文件系统。
1、因为服务器需要将各种数据、文件等放置到不同的地方。
2、比如用户数据可能大多数是放到数据库中的
3、比如某些配置文件或者用户资源(图片、音视频)都是以文件的形式存在于操作系统上的
Node也有自己的文件系统操作模块,就是fs:
1、借助Node帮助我们封装的文件系统,我们可以在任何操作系统(window、Mac OS、Linnx)上面直接去操作文件
2、这也是Node可以开发服务器的一大原因,也是它可以成为前端自动化脚本等热门工具的原因
fs文件系统的API大多数都提供三种操作方式
1、方式一:同步操作文件:代码会被阻塞,不会继续执行;
2、方式二:异步回调函数操作文件:代码不会被阻塞,需要传入回调函数,当获取到结果时,回调函数被执行
3、方式三:异步Promise操作文件:代码不会被阻塞,通过fs.promises调用方法操作,会返回一个promise,可以通过then、catch进行处理。
案例分析
const fs = require('fs');
// 方式一:同步读取文件
const state = fs.statSync('./abc.txt')
console.log(state);
console.log('后续代码执行');
// 方式二:异步读取
fs.stat('./abc.txt',(err,state)=>{
    if(err){
        console.log(err);
        return
    }

console.log(state);})
console.log('后续代码执行');
// 方式三:promise方式
fs.promises.stat('./abc.txt').then(state=>{
    console.log(state);
}).catch(err=>{
    console.log(err);
})

console.log("后续代码执行");
文件描述符
为了简化用户工作,Node.js抽象出操作系统之间的特定差异,并为所有打开的文件分配一个数字型的文件描述符。
**fs.open()**方法用于分配新的文件描述符,一旦被分配,则文件描述符可用于从文件读取数据,向文件写入数据,或请求关于文件的信息。
fs.open('./abc.txt',(err,fd)=>{
    if(err){
        console.log(err);
        return
    }
    console.log(fd);// 这里该文件被分配了3
    })
fs.open('./abc.txt',(err,fd)=>{
    if(err){
        console.log(err);
        return
    }
    // 打印文件描述符
    console.log(fd);
    // 通过描述符去获取文件的信息
    fs.fstat(fd,(err,info)=>{
        console.log(info);
    })})
文件的读写
如果我们希望对文件的内容进行操作,这个时候可以使用文件的读写
1、fs.writeFile(file,data [,options] ,callback) :在文件中写入内容
可选[,options]有两个参数:flag(写入的方式)、encoding(字符的编码)
// 文件的写入
const content = "为了更好的明天而战!"
fs.writeFile('./abc.txt',content,err=>{
    console.log(err);
})
在文件后面追加
// 文件的写入
const content = "为了更好的明天而战!"
fs.writeFile('./abc.txt',content,{flag:"a"},err=>{
    console.log(err);
})
2、fs.readFile(path [,options],callback) :读取文件的内容;
// 文件的读取
fs.readFile('./abc.txt',{encoding:'utf-8'},(err,data)=>{
    console.log(data);
})
参数:flag选项
- w打开文件写入,默认值(会覆盖原有的内容)
- w+打开文件进行读写,如果文件不存在则创建文件
- r+打开文件进行读写,如果不存在那么抛出异常
- r打开文件读取,读取文件时的默认值
- a打开要写入的文件,将流放在文件末尾。如果不存在则创建文件
- a+打开文件以进行读写,将流放在文件末尾。如果不存在则创建文件
参数:encoding选项
目前普遍采用utf-8字符编码
如果不填写encoding,则返回的结果是Buffer
对文件夹的操作
1、创建文件夹
// 创建文件夹
const dirname = './ming';
if(!fs.existsSync(dirname)){
    //如果不存在相同的文件名
    fs.mkdir (dirname,err =>{
        console.log(err);
    })}
2、读取文件夹下的所有文件
const dirname = './ming';
fs.readdir(dirname,(err,files) => {
    console.log(files);
})
但是如果文件夹下包含了其他文件夹呢?用上边的方法读取不会去读取其他文件夹里边的文件
const dirname = './ming';

function getFiles(dirname) {
    fs.readdir(dirname,{withFileTypes:true},(err,files) => {
        for(let file of files) {
            if (file.isDirectory()) {
                const filepath = path.resolve(dirname,file.name);
                getFiles(filepath);
            }else {
                console.log(file.name);
            }
        }
    })
}
getFiles(dirname)
3、文件夹重命名
// 文件夹重命名
fs.rename('./ming','./linming',err=>{
    console.log(err);
})
其他常用API
- writeFile 从指定文件中读取数据
- appendFile 追加的方式向指定文件中写入数据
- copyFile 将某个文件中的数据拷贝至另一个文件
- watch File 对指定文件进行监控
3.3 events模块
Node中的核心API都是基于异步事件驱动的:
1、在这个体系中,某些对象(发射器(Emiters))发出一个事件,我们可以监听这个事件(监听器(listeners),并且传入的回调函数,这个回调函数会在监听到事件时调用;
2、发出事件和监听事件都是通过EventEmiter类来完成的,他们都属于events对象
a、emitter.on( eventName,listener) :监听事件,也可以使用addListener
b、emitter.off( eventName,listener) :移除事件监听,也可以使用removeListener
c、emitter.emit(eventName [,args]) :发出事件,可以携带一些参数
// 1、创建发射器
const emitter = new EventEmitter()

// 2.监听某一个事件
emitter.on('btnClick',(args)=>{
    console.log('监听到了',args);
})
// 发出某一个事件
setTimeout(()=>{
    emitter.emit('btnClick',{name:"linming"});
},2000)
停止监听某一事件,需要写成以下写法
emitter.on('btnClick2',(args)=>{
    console.log('监听到了',args);})

const listener2 = (args) =>{
    console.log('监听到了',args);
}

emitter.on('btnClick',listener2)

setTimeout(()=>{
    emitter.emit('btnClick',{name:"linming"});
    emitter.emit('btnClick2',"linming");
    emitter.off('btnClick',listener2);
},2000)
四、包管理工具npm
Node package Manager
4.1 package.json
事实上,每一个项目(无论是前端项目还是后端项目),都有一个对应的配置文件。
说明:这个配置文件记录着项目的名称、版本号、项目描述等,也记录着项目所依赖的其他库的信息和依赖的版本号。
常见的属性
1、name是项目的名称;(必要)
2、version是当前项目的版本号;(必要)
3、description是描述信息,很多时候是作为项目的基本描述;
4、author是作者相关信息(发布时用到);
5、license是开源协议(发布时用到);
6、scripts属性——该属性用于配置一些脚本命令,以键值对的形式存在。配置后我们就可以通过npm run 命令的key来执行这个命令
7、dependencies属性——指定无论开发环境还是生产环境都需要依赖的包
8、devDependencies属性——通过npm install ** --save -dev 安装我的包,开发时依赖,项目上线后不需要
版本管理的问题
我们安装的版本依赖:^2.0.3 或者 ~2.0.3 这是什么意思呢?
npm的包通常需要遵从semver版本规范
1、X主版本号:当发布了不兼容之前版本的API修改(如webpack4升级到webpack5)
2、Y次版本号:当做了向下兼容的功能性新增(新功能增加)
3、Z修订号:当做了向下兼容的问题修正(没有新功能,修复之前版本的bug)
^ 和 ~ 的区别
1、^x.y.z:表示x是保持不变的,y和z永远安装最新的版本;
2、~x.y.z:表示x和y保持不变的,z永远安装最新的版本
4.2 npm install
1、全局安装: npm install <包> -g
2、局部安装:npm install <包>
其中局部安装分为开发时依赖和生产时依赖:
安装开发和生产依赖:npm install <包>
开发依赖:npm install <包> -dev
注:--save是表示将依赖关系添加到package.json中,但是npm5之后可以省略。
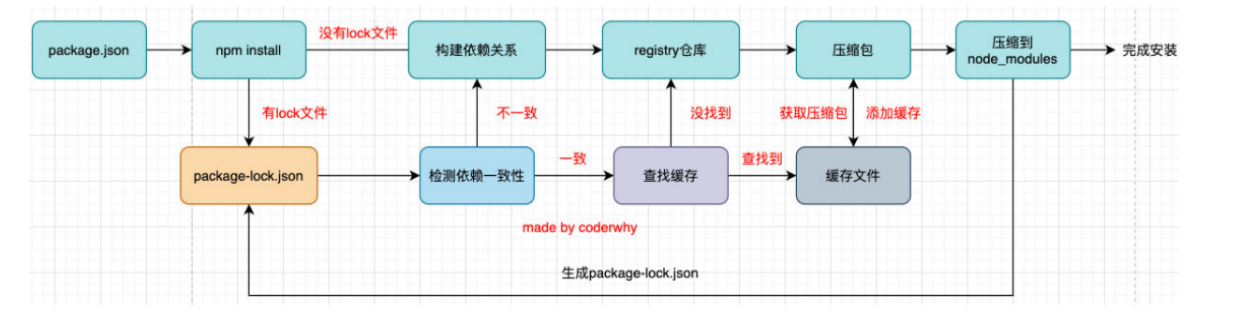
npm install会检测是有package-lock.json文件。
其他命令
卸载某个依赖包:npm uninstall <package>
强制重新build :npm rebuild
清除缓存:npm cache clean
下载源
查看当前源: npm config get resistry
下载淘宝镜像源:npm install -g cnpm --registry=https://registry.npm.taobao.org
当前源切换为淘宝的源:npm config set registry https://registry.npm.taobao.org
切换为官方源:npm config set registry https://registry.npmjs.org/
rimraf
rimraf 这是一个nodejs库,库官方地址: https://www.npmjs.com/package/rimraf。用来删除文件和文件夹的,不管文件夹是否为空,都可删除
安装 局部安装:npm install rimraf --save-dev 全局安装:npm install rimraf -g 使用:rimraf [ ...]
利用该库我们可以很快速地删除node_modules包rimraf node_modules
也可以在项目中使用npm install rimraf –save-dev
"build": "vite build && rimraf dist/config.js" // vite 打包时删除本地config.js
4.3 其他工具
yarn
yarn是为了弥补npm的一些缺陷而出现的
常见的命令:
安装依赖:yarn install
填加包:yarn add <package>
移除包 :yarn remove <package>
cnpm
查看当前npm镜像
npm config get registry
输出(npm镜像):#npm config get registry
输出(淘宝镜像):#httpS://r.npm.taobao.org/
我们可以直接将npm命令设置为淘宝镜像(不推荐)
npm config set registry https://registry.npm.taobao.org
比较推荐将镜像绑定在cnpm上,并且将cnpm设置为淘宝的镜像,这样子不会影响原来npm命令的使用。
npm install -g cnpm --registry=https://registry.npm.taobao.org
五、构建脚手架工具
创建项目
1、index.js
#!/usr/bin/env node
console.log("实现自己的命令:执行index.js");
2、创建package.json,并修改
  "bin": {
    "mzlin": "index.js"
  },
3、执行 npm link
这样子就可以在终端通过mzlin来执行index.js文件了
定义version与help
npm install commander -g
查看版本号
const program = require('commander')
// 定义版本号
program.version(require('./package.json').version)

// 解析终端指令
program.parse(process.argv)
增加其他的options
//index.js
#!/usr/bin/env node
const {helpOptions} = require('./lib/core/help.js')

// 帮助可选信息
helpOptions();

// 解析终端指令
program.parse(process.argv)

//help.js
const program = require('commander')
function helpOptions () {
    // option选项
    program.option('-m --mzlin','a mzlin option');
    program.option('-s --src <src>','a source folder')
    program.option('-d --dest <dest>','a destination dolder 例如: -d src/pages')
    // 监听--help的执行,并回调函数
    program.on('--help',function() {
        console.log("");
        console.log("other:");
        console.log('  other options~');
    })}

module.exports = {
    helpOptions
}
创建项目指令
思路:
1、创建解析create指令
2、通过download-git-repo从代码仓库中下载模板
3、进入目录并执行npm install命令
4、执行npm run serve 命令、打开浏览器
//1.创建解析create指令
//create.js
const program = require('commander')

// 将action的代码逻辑抽离出去
const {
    createProjectAction
} = require('./actions')

const createCommands = () => {
    // 创建create指令
    program
        .command('create <project> [others...]')
        .description('clone a repository into a folder')
        .action(createProjectAction)
}

module.exports = {
    createCommands
}

//index.js
const {createCommands} = require('./lib/core/create')
// 执行创建的命令
createCommands()
//2、通过download-git-repo从代码仓库中下载模板
后续学习......
六、buffer
6.1buffer与二进制
对于前端开发来说,通常很少会和二进制打交道,但是对于服务器端为了做很多的功能,我们必须直接去操作其二进制的数据。
所以,Node为了方便开发者完成更多的功能,提供了一个类Buffer,并且是全局的。
Buffer中存储的是二进制数据,是怎样存储的呢?我们可以将Buffer看成是一个存储二进制的数组,这个数组中的每一项,都可以保存8位二进制:00000000
//将字符串放进buffer中
const message = 'hello';

// 创建方式一  (该方式已过时)
const buffer1 = new Buffer(message);
console.log(buffer1);

//创建方式二 推荐
const buffer2 = Buffer.from(message);
console.log(buffer2);
//输出 <Buffer 68 65 6c 6c 6f>
//一个字母对应一个16进制(默认使用了utf-8)
如果存储的是中文呢
const message2 = '你好';
const buffer3 = Buffer.from(message2);
console.log(buffer3);
//输出:<Buffer e4 bd a0 e5 a5 bd>
//一个中文对应3位16进制(默认使用了utf-8)

//解码 :buffer -> string
const str = buffer3.toString('utf8')
console.log(str);
buffer还有一种常见的创建方式:Buffer.alloc
const buffer4 = Buffer.alloc(8);
console.log(buffer4);
//输出: <Buffer 00 00 00 00 00 00 00 00>
//创建了8位长度的buffer
我们可以操作其中的每一位
buffer4[0] = 88;
console.log(buffer4);
//输出:<Buffer 58 00 00 00 00 00 00 00>
//88 转16进制 = 58

//如果直接存入88呢
buffer4[1] = 0x88;
console.log(buffer4);
//输出:<Buffer 58 88 00 00 00 00 00 00>
buffer的实例方法
- fill 使用数据填充buffer
- write 向buffer中写入数据
- toString 从buffer中提取数据
- slice 截取buffer
- indexOf 在buffer中查找数据
- copy 拷贝buffer中的数据
静态方法
- concat 拼接多个buffer
- isBuffer 判断传入的数据是否是buffer
6.2 buffer与文件读取
在不写入读取文件的字符编码时,readFile不会对读取的文件进行解码,会直接返回一个buffer
fs.readFile('./info.txt',(err,data) => {
    console.log(data)
});
//输出:<Buffer e4 bd a0 e5 a5 bd e5 95 8a ef bc 8c e6 98 8e e5 a4 a9>

fs.readFile('./info.txt',{encoding:'utf-8'},(err,data) => {
    console.log(data)
});
//输出:你好啊
读取图片
fs.readFile('./头像.jpg',(err,data) => {
    console.log(data);
})
//输出:<Buffer ff d8 ff e0 00 10 4a 46 49 46 00 01 01 01 00 48 00 48 00 00 ff e1 00 bc 45 78 69 66 00 00 4d 4d 00 2a 00 00 00 08 00 05 01 12 00 03 00 00 00 01 00 01 ... 129667 more bytes>
fs.readFile('./头像.jpg',(err,data) => {
    console.log(data); //输出buffer
    fs.writeFileSync('./head.jpg',data)   //将buffer重新转化为图片
})
事实上,我们创建Buffer时,并不会频繁向操作系统申请内存,它会默认先申请一个8*1024个字节大小的内存,即8kb。
七、事件循环和异步IO
7.1 事件循环
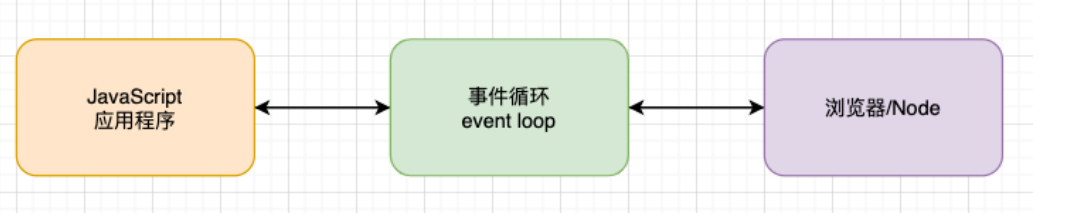
事件循环可以理解为我们编写的JavaScript代码和浏览器或者Node之间的一个桥梁。
- 浏览器的事件循环是JavaScript代码和浏览器API调用(如setTimeout等)的一个桥梁。桥梁间通过回调函数进行沟通
- Node的事件循环是JavaScript代码和系统调用(file system)之间的桥梁。桥梁间通过回调函数进行沟通
7.2 进程和线程
进程和线程是操作系统中的两个概念:
- 进程(process):计算机已经运行的程序。
可以认为电脑每启动一个应用程序,就会默认启动一个进程(有可能是多个)。
- 线程(thread):操作系统能够运行运算调度的最小单位。
启动的每一个进程中,都会对应启动一个(或多个)线程来执行其中的代码。可以说进程就是线程的一个容器。
可以这么理解,操作系统类似于一个工厂,工厂里边有很多车间,车间就相当于进程,每个车间有一个以上的工人,工人就相当于线程。
**多进程多线程开发 **
操作系统是如何做到同时让多个进程(边听歌、边写代码、边查阅资料)同时工作呢?
这是因为CPU的运算速度非常快,它可以快速的在多个进程之间迅速的切换,对于用户来说是感受不到这种快速的切换的。
浏览器和JavaScript
JavaScript是单线程的,JavaScript的线程有自己的容器(进程):浏览器或者Node
- 浏览器
目前多数的浏览器其实都是多进程的,当我们打开一个tab页面时就会开启一个新的进程,这是为了防止一个
页面卡死而造成所有页面无法响应,整个浏览器需要强制退出;
每个进程中(如每个tab页面)又有很多的线程,其中包括执行JavaScript代码的线程;
JavaScript的代码是在一个单独的线程中执行的,这就是意味着同一时刻只能做一件事,如果这件事非常耗时,就意味着当前的线程会被阻塞。
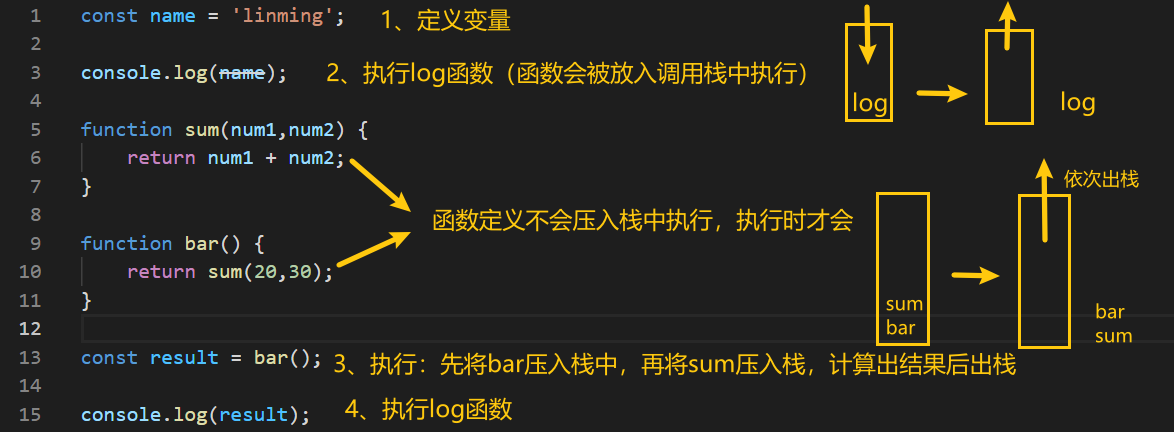
我们来看这段js代码是怎么执行的
const name = 'linming';

console.log(name);

function sum(num1,num2) {
    return num1 + num2;
}

function bar() {
    return sum(20,30);
}

const result = bar();

console.log(result);
注:函数执行时,会被放入栈中执行
7.3 浏览器的事件循环
浏览器执行代码时是自上而下的
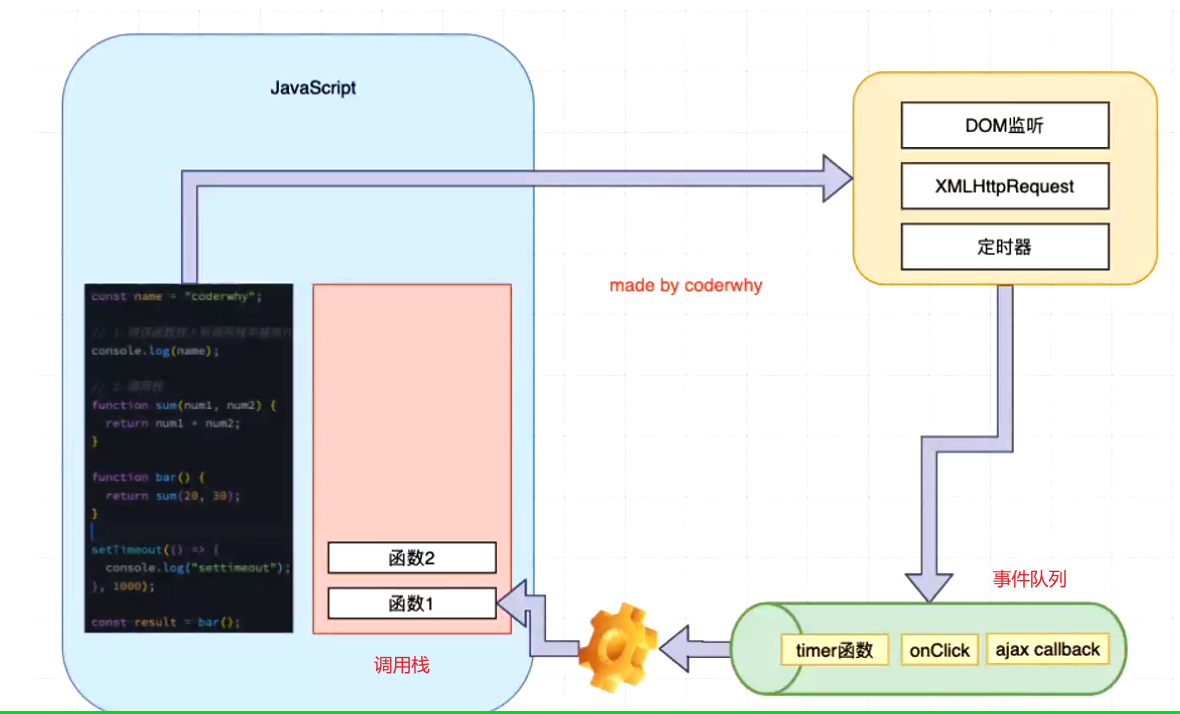
如果在执行JavaScript代码过程中,有异步操作,是怎么的一个过程呢?
比如运行一个setTimeout函数
setTimeout(() => {
    console.log('我在事件队列中执行')
},1000)
1、执行时,会将该函数(setTimeout)放进调用栈中,执行立即结束,并不会阻塞后续代码的执行。
2、回调函数此时不会在调用栈中,等待时间一到,该回调函数会被加入到事件队列中。
3、事件队列中的任务会按照先进先出的顺序依次进行调用栈中执行。
宏任务和微任务
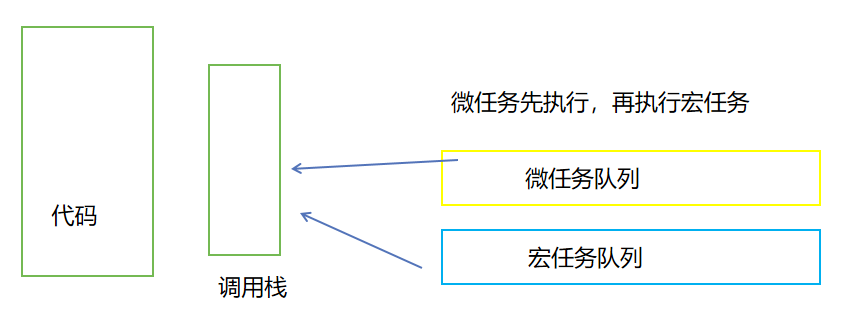
事件循环并非只维护着一个队列,事实上有两个队列
1、宏任务队列(macrotask queue):ajsx、setTimeout、setInterval、DOM监听等
2、微任务队列(microtask queue):Promise的then回调、Mutatation Observer API、queueMicrotask等
事件循环对于两个队列的优先级是怎么样的呢?
1、main script中的代码优先执行(编写的顶层script代码)
2、在执行任何一个宏任务之前,都会先查看微任务队列是否有任务需要执行。(也就是宏任务执行之前,必须保证微任务队列是空的。如果不为空,那么优先执行微任务队列中的任务)
面试题
求一下代码的打印顺序
setTimeout(function () {
    console.log("set1");
    new Promise(function (resolve) {
      resolve();
    }).then(function () {
      new Promise(function (resolve) {
        resolve();
      }).then(function () {
        console.log("then4");
      });
      console.log("then2");
    });
  });

  new Promise(function (resolve) {
    console.log("pr1");
    resolve();
  }).then(function () {
    console.log("then1");
  });

  setTimeout(function () {
    console.log("set2");
  });

  console.log(2);

  queueMicrotask(() => {
    console.log("queueMicrotask1")
  });

  new Promise(function (resolve) {
    resolve();
  }).then(function () {
    console.log("then3");
  });
1、首先在调用栈中执行setTimeout,里边的回调函数放进宏任务中

2、接着执行setTimeout后的promise,打印出pr1,并将then1放进微任务

3、紧着执行第二个setTimeout并跳出,并将set2放进宏任务。再直接执行log(2)函数

4、执行queueMicrotask,添加进微任务

5、执行最后一个promise,将then3加进微任务

6、至此,开始执行微任务的回调函数

7、执行完微任务,开始执行宏任务。首先执行的是set1的回调函数。打印了set1,并将里边的then2加入微任务,再将then4加入微任务

8、执行微任务里边的then2、then4,此时输出:pr1、2、then1、queueMicrotask1、then3、 set1、then2、then4
9、最后回到宏任务执行set2的回调,打印出最后的set2
八、Stream
8.1 概述
stream(流)
程序中的流
类似于现实中的流水,源源不断地流动。可以想象当我们从一个文件中读取数据时,文件的二进制(字节)数据会源源不断的被读取到我们程序中。这一连串的字节,就是程序中的流
理解流
流是连续字节的一种表现形式和抽象概念,流是可读的,也是可写的
官方解释:所有的流都是EventEmitter的实例。事实上Node中很多对象都是基于流实现的,如http模块中的Request和Response对象、process.stdout对象
为什么需要流?
1、利用readFile和writeFile的方式读写文件无法控制一些细节的操作。
如从什么位置开始读,读到什么位置,一次性读取多少字节、读到某个位置后,暂停读取等等。
2、文件非常大,一次性读取不合适。比如一个视频文件
8.2 文件读写的Stream
Node.js中有四种基本流类型
1、Writable:可以向其写入数据的流
2、Readable:可以从中读取数据的流
3、Duplex:兼顾Readable和Writable
4、Transform:Duplex可以在写入和读取数据时修改或者转换数据的流
读取文件
// 传统的读取文件
fs.readFile('./abc.txt',{encoding:'utf-8'},(err,data) =>{
    console.log(data);
})
//注添加编码方式,默认data是一个buffer
// 流的方式读取文件
const reader = fs.createReadStream('./abc.txt',{
    start:3,
    end:6,
    highWaterMark:2
})

// 数据读取的过程
reader.on('data',(data) => {
    console.log(data);
})

// 监听流开始读取
reader.on('open',() => {
    console.log('文件被打开了');
})

// 监听流关闭
reader.on('close',() => {
    console.log('文件关闭了');
})
数据读取也可以中断读取pause(),恢复读取resume()
// 数据读取的过程
reader.on('data',(data) => {
    console.log(data);

    reader.pause(); //暂停

    setTimeout(() => {
        reader.resume()
    },1000)
})
写入文件
// 传统的写入方式
fs.writeFile('./foo.txt',"hello world",{flag:'a'},(err) => {
    console.log(err);
})
// stream的写入方式
const writer = fs.createWriteStream('./foo.txt',{
    flags:"a",
    start:4
})

writer.write("你好啊",(err) => {
    console.log("写入成功");
})

// 在末尾追加内容后关闭流
writer.end('结束吧')
// 也可以使用close()

// 监听文件流是否真的关闭了
writer.on('close',() => {
    console.log("文件关闭了");
})
pipe的使用
读取一个文件的全部内容,写入另外一个文件中
const fs = require('fs')

// // 传统写法
// fs.readFile('./abc.txt',(err,data) => {
//     fs.writeFile('./cba.txt',data,(err) => {
//         console.log(err);
//     })
// })

// Stream写法
const reader = fs.createReadStream("./abc.txt");
const writer = fs.createWriteStream("./bac.txt")

reader.pipe(writer);
writer.close()